RAG · AI Agent 데이터 파이프라인 가이드
LlamaIndex 완전 가이드
LlamaIndex로 고급 RAG 파이프라인, ReAct Agent, 서브쿼리 분해와 하이브리드 검색을 구축합니다. ChromaDB·Pinecone 연동, RAGAS 평가와 프로덕션 운영까지 정리합니다.
- 고급 RAG
- ReAct Agent
- Sub-question
- Hybrid Search
- Vector DB
- RAGAS
LlamaIndex 웹 IDE 열기 →
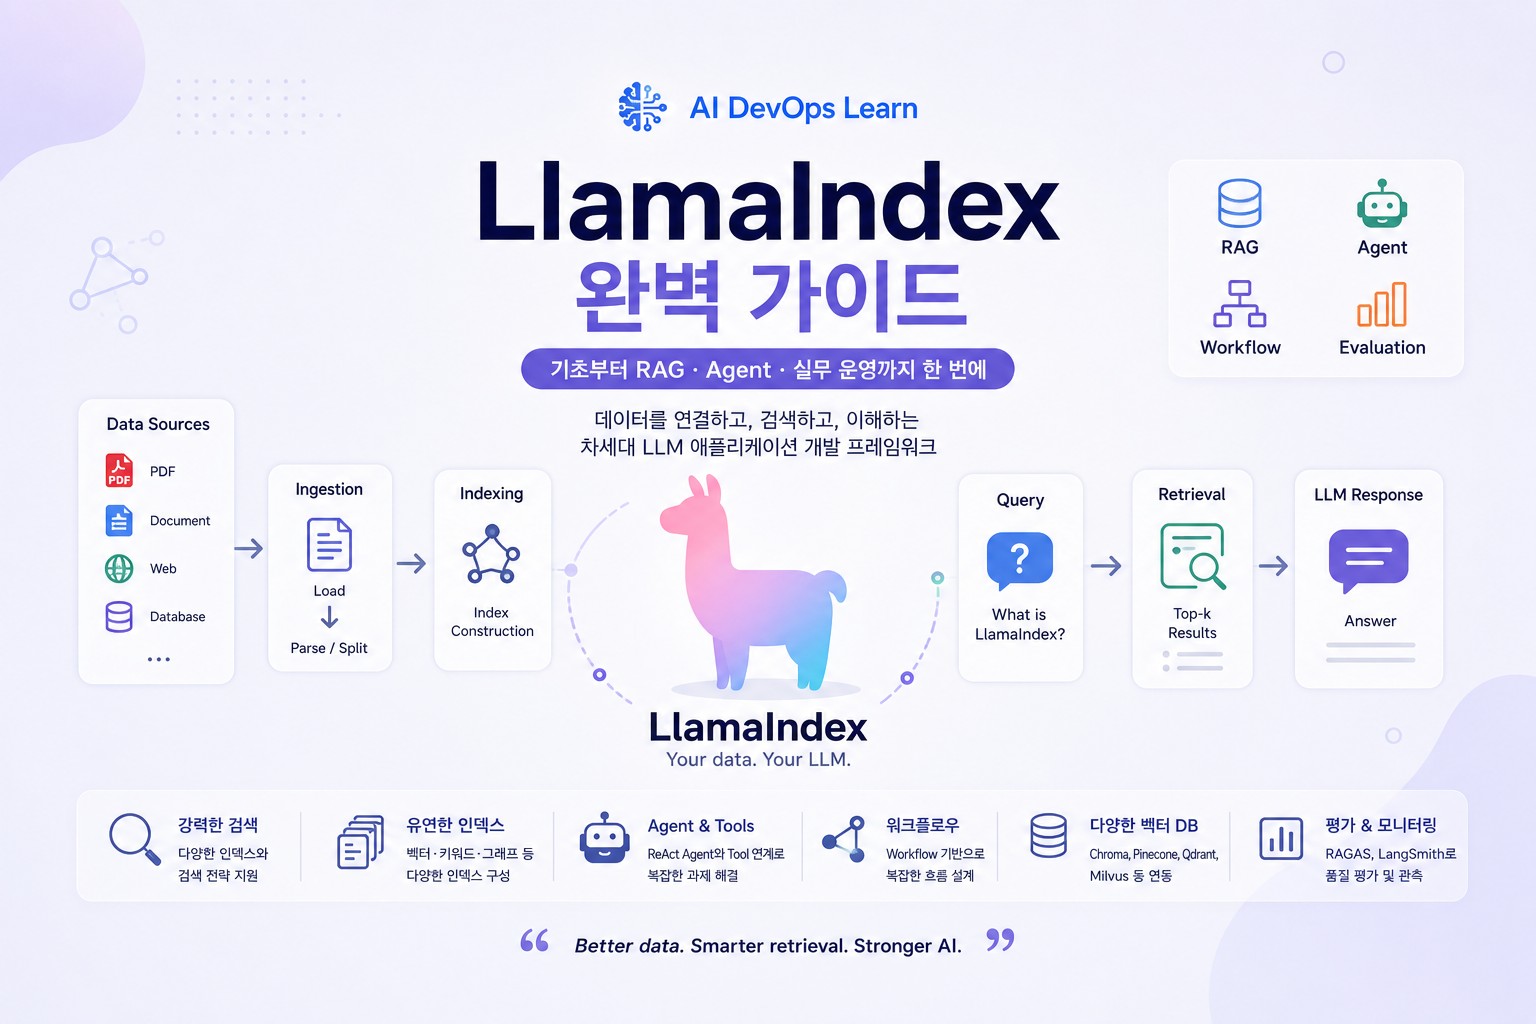
LlamaIndex는 문서 수집과 파싱, 인덱싱, 검색, 응답 생성을 연결하는 데이터 중심 LLM 프레임워크입니다. 검색 품질은 모델 크기보다 chunking, metadata, retriever, reranker와 평가 데이터셋의 영향을 크게 받습니다.
1. 핵심 아키텍처
LlamaIndex는 데이터 수집 → 인덱싱 → 검색 → 생성의 전 과정을 추상화합니다. VectorStoreIndex는 임베딩 기반 의미 검색에, SummaryIndex는 문서 전체 요약에 적합합니다. Settings로 LLM과 임베딩 모델, chunk 설정을 공통 관리할 수 있습니다.
Document
Chunking
Retriever
Query Engine
| 인덱스 유형 | 특징 | 적합한 용도 |
|---|---|---|
| VectorStoreIndex | 임베딩 유사도 기반 검색 | 의미 검색, FAQ, 지식베이스 |
| SummaryIndex | 전체 노드를 순차적으로 처리 | 문서 전체 요약, 긴 리포트 |
| KeywordTableIndex | 키워드 중심 문서 탐색 | 정확한 용어 검색, 전문 문서 |
| KnowledgeGraphIndex | 엔티티와 관계를 기반으로 탐색 | 다중 홉 질문, 관계형 지식 탐색 |
from llama_index.core import Settings
from llama_index.llms.openai import OpenAI
from llama_index.embeddings.openai import OpenAIEmbedding

# 전역 설정
Settings.llm = OpenAI(
    model="gpt-4o",
    temperature=0.1,
)

Settings.embed_model = OpenAIEmbedding(
    model="text-embedding-3-small",
)

Settings.chunk_size = 512
Settings.chunk_overlap = 50
2. 고급 인덱싱 전략
고정 크기 chunking은 문장을 중간에서 끊어 검색 품질을 떨어뜨릴 수 있습니다. Sentence Window 전략은 문장을 검색 단위로 사용하면서 주변 문장을 함께 보존합니다. Hierarchical 또는 Auto-Merging 전략은 작은 노드를 검색한 뒤 상위 문맥을 반환해 세부 정보와 전체 흐름을 함께 제공합니다.
Sentence Window 인덱싱from llama_index.core import VectorStoreIndex
from llama_index.core.indices.postprocessor import (
MetadataReplacementPostProcessor,
SentenceTransformerRerank,
)
from llama_index.core.node_parser import (
SentenceWindowNodeParser,
)
window_parser = SentenceWindowNodeParser.from_defaults(
window_size=3,
window_metadata_key="window",
original_text_metadata_key="original_text",
)
nodes = window_parser.get_nodes_from_documents(
documents
)
window_index = VectorStoreIndex(nodes)
window_query_engine = window_index.as_query_engine(
node_postprocessors=[
MetadataReplacementPostProcessor(
target_metadata_key="window",
),
SentenceTransformerRerank(
top_n=3,
model="BAAI/bge-reranker-base",
),
]
)3. 하이브리드 검색과 리랭킹
의미 검색은 표현이 다른 유사 문서를 잘 찾지만 정확한 코드나 전문 용어를 놓칠 수 있습니다. BM25 검색은 정확한 키워드에 강하지만 유사 의미 표현에는 약합니다. 두 결과를 RRF로 결합하고 cross-encoder reranker를 추가하면 검색 재현율과 상위 결과의 정밀도를 함께 개선할 수 있습니다.
Pythonfrom llama_index.core.query_engine import (
RetrieverQueryEngine,
)
from llama_index.core.retrievers import (
QueryFusionRetriever,
)
from llama_index.postprocessor.cohere_rerank import (
CohereRerank,
)
from llama_index.retrievers.bm25 import (
BM25Retriever,
)
vector_retriever = index.as_retriever(
similarity_top_k=10,
)
bm25_retriever = BM25Retriever.from_defaults(
nodes=nodes,
similarity_top_k=10,
)
hybrid_retriever = QueryFusionRetriever(
[vector_retriever, bm25_retriever],
similarity_top_k=10,
num_queries=4,
mode="reciprocal_rerank",
)
reranker = CohereRerank(
api_key="co_your_api_key",
top_n=3,
)
query_engine = RetrieverQueryEngine(
retriever=hybrid_retriever,
node_postprocessors=[reranker],
)Cohere, OpenAI와 벡터 DB API Key를 코드에 직접 입력하지 마세요. 로컬에서는 환경 변수, 운영에서는 Secret Manager 또는 Kubernetes Secret으로 관리하세요.
4. ReAct Agent
ReAct Agent는 생각, 행동, 관찰 과정을 반복해 복잡한 질문을 해결합니다. 여러 Query Engine을 도구로 등록하면 Agent가 질문에 적합한 데이터 소스를 선택할 수 있습니다. 무한 반복과 과도한 모델 호출을 막기 위해 최대 실행 횟수를 제한해야 합니다.
Pythonfrom llama_index.core.agent import ReActAgent
from llama_index.core.tools import (
QueryEngineTool,
ToolMetadata,
)
knowledge_tool = QueryEngineTool(
query_engine=query_engine,
metadata=ToolMetadata(
name="knowledge_base",
description=(
"회사 내부 문서, 정책과 절차를 검색합니다. "
"구체적인 질문을 입력하세요."
),
),
)
agent = ReActAgent.from_tools(
[knowledge_tool],
verbose=True,
max_iterations=10,
)
response = agent.chat(
"분기별 매출 트렌드를 분석하고 이상치를 찾아줘"
)
print(response)검색 외에 파일 변경, 이메일 발송, 데이터베이스 수정과 같은 Tool을 연결할 때는 최소 권한, 입력 검증, 사용자 승인과 실행 기록을 적용하세요.
5. 이벤트 기반 워크플로우
Workflow는 비동기 이벤트 그래프로 복잡한 RAG 파이프라인을 명시적으로 표현합니다. 각 step은 입력 이벤트를 받아 새로운 이벤트 또는 종료 이벤트를 반환합니다. 조건 분기와 병렬 처리, 단계별 테스트가 필요한 흐름에 적합합니다.
Pythonfrom llama_index.core import Settings
from llama_index.core.workflow import (
Event,
StartEvent,
StopEvent,
Workflow,
step,
)
class RetrievalEvent(Event):
nodes: list
query: str
class RAGWorkflow(Workflow):
@step
async def retrieve(
self,
ev: StartEvent,
) -> RetrievalEvent:
retriever = index.as_retriever(
similarity_top_k=5,
)
nodes = await retriever.aretrieve(
ev.query
)
return RetrievalEvent(
nodes=nodes,
query=ev.query,
)
@step
async def generate(
self,
ev: RetrievalEvent,
) -> StopEvent:
context = "\n".join(
node.get_content()
for node in ev.nodes
)
response = await Settings.llm.acomplete(
f"컨텍스트:\n{context}\n\n"
f"질문: {ev.query}"
)
return StopEvent(
result=str(response),
)
workflow = RAGWorkflow(timeout=60)
result = await workflow.run(
query="핵심 내용을 요약해줘"
)6. Sub-question 분해
여러 데이터 소스에 걸친 질문은 하나의 검색기로 답하기 어렵습니다. SubQuestionQueryEngine은 복합 질문을 여러 하위 질문으로 분해하고, 각 질문에 적합한 Query Engine을 호출한 뒤 결과를 통합합니다.
from llama_index.core.query_engine import (
    SubQuestionQueryEngine,
)
from llama_index.core.tools import (
    QueryEngineTool,
    ToolMetadata,
)

tools = [
    QueryEngineTool(
        query_engine=sales_engine,
        metadata=ToolMetadata(
            name="sales_2024",
            description=(
                "2024년 월별·분기별 매출 데이터. "
                "금액, 수량과 지역 정보를 포함합니다."
            ),
        ),
    ),
    QueryEngineTool(
        query_engine=hr_engine,
        metadata=ToolMetadata(
            name="hr_data",
            description=(
                "인사 데이터. 입사일, 부서, 직급과 "
                "성과 평가 정보를 포함합니다."
            ),
        ),
    ),
]

engine = SubQuestionQueryEngine.from_defaults(
    query_engine_tools=tools,
    verbose=True,
)

response = engine.query(
    "2024년 신규 직원의 성과와 매출 기여도는?"
)

print(response)
7. 벡터 DB 통합
메모리 기반 인덱스는 서버가 재시작되면 사라질 수 있습니다. 운영에서는 ChromaDB, Pinecone, PostgreSQL pgvector 등 영구 벡터 저장소를 사용하고 인덱스 재사용과 갱신 정책을 관리해야 합니다.
ChromaDB 영구 저장import chromadb
from llama_index.core import (
StorageContext,
VectorStoreIndex,
)
from llama_index.vector_stores.chroma import (
ChromaVectorStore,
)
chroma_client = chromadb.PersistentClient(
path="./chroma_db"
)
collection = chroma_client.get_or_create_collection(
name="company_docs",
metadata={
"hnsw:space": "cosine",
},
)
vector_store = ChromaVectorStore(
chroma_collection=collection,
)
storage_context = StorageContext.from_defaults(
vector_store=vector_store,
)
# 최초 인덱싱
index = VectorStoreIndex.from_documents(
documents,
storage_context=storage_context,
show_progress=True,
)
# 기존 컬렉션을 다시 사용할 때
index = VectorStoreIndex.from_vector_store(
vector_store
)벡터 저장소 운영 시 확인할 항목
- 문서 ID와 chunk ID를 재현 가능하게 생성합니다.
- 문서 변경 및 삭제 시 기존 vector를 함께 정리합니다.
- embedding 모델이 바뀌면 기존 index와 혼합하지 않습니다.
- collection, namespace 또는 tenant 단위로 접근 권한을 분리합니다.
- 검색 latency와 vector DB 장애에 대한 timeout과 fallback을 설정합니다.
8. RAGAS 평가
RAG 시스템의 품질은 느낌이 아니라 고정된 평가셋으로 측정해야 합니다. Faithfulness는 답변이 검색 문서에 근거하는지, Answer Relevancy는 질문과 답변의 관련성을, Context Recall은 정답에 필요한 정보가 검색되었는지 평가합니다.
Pythonfrom datasets import Dataset
from ragas import evaluate
from ragas.metrics import (
answer_relevancy,
context_recall,
faithfulness,
)
eval_dataset = Dataset.from_dict({
"question": questions,
"answer": answers,
"contexts": contexts,
"ground_truth": ground_truths,
})
result = evaluate(
eval_dataset,
metrics=[
faithfulness,
answer_relevancy,
context_recall,
],
)
dataframe = result.to_pandas()
print(
dataframe[
[
"question",
"faithfulness",
"answer_relevancy",
"context_recall",
]
]
)9. LlamaIndex 실무 설계
ingestion 파이프라인과 query 파이프라인을 분리하면 문서 재색인과 검색 전략 튜닝을 독립적으로 수행할 수 있습니다. 문서 파싱, metadata, embedding과 index 버전을 함께 추적해야 검색 결과와 장애 원인을 재현할 수 있습니다.
| 결정 지점 | 확인 질문 | 실무 기준 |
|---|---|---|
| 수집 | 어떤 문서가 언제 들어왔는가? | 원본 문서 ID, 버전, 수집 시각과 출처를 기록합니다. |
| Chunk | 검색 결과에서 원문 위치를 확인할 수 있는가? | 페이지, 제목, 섹션과 URL을 metadata로 보존합니다. |
| Index | 어떤 embedding 모델로 생성했는가? | 모델명, dimension과 index 버전을 함께 관리합니다. |
| Retriever | top-k와 reranker 설정을 재현할 수 있는가? | 검색 설정을 코드 밖의 구성으로 분리합니다. |
| 장애 | 검색이나 LLM이 실패하면 무엇을 반환하는가? | timeout, fallback과 error contract를 정의합니다. |
권장 프로젝트 구조
Directoryllamaindex-project/
├── app/
│ ├── api/
│ ├── agents/
│ ├── ingestion/
│ ├── indexes/
│ ├── query_engines/
│ ├── retrievers/
│ ├── workflows/
│ └── settings.py
├── evaluations/
│ ├── rag_dataset.jsonl
│ └── regression_cases.jsonl
├── storage/
├── tests/
└── pyproject.toml10. 운영 기준
운영에서는 embedding 비용, index refresh 주기, vector DB latency, top-k, reranker 비용과 LLM token 사용량을 함께 관리해야 합니다.
- 문서 수집과 재색인 작업을 query API와 분리합니다.
- 문서·chunk·embedding·index 버전을 연결해 기록합니다.
- 검색 latency, reranker latency와 LLM latency를 구분해 측정합니다.
- 검색 결과와 최종 답변의 citation을 검증합니다.
- 문서 접근 권한을 검색 단계에서 적용합니다.
- 변경된 문서의 삭제 및 재색인 정책을 마련합니다.
- 외부 LLM, reranker와 vector DB 장애에 fallback을 준비합니다.
- 질문, 검색 문서와 답변 로그에서 개인정보를 보호합니다.
11. 검증 전략
검색 품질은 context recall과 precision, citation 정확도와 응답 충실도를 기준으로 평가해야 합니다. 실제 장애나 잘못된 답변 사례는 고정 평가 데이터에 추가해 회귀 테스트로 유지합니다.
| 품질 축 | 검증 방법 | 완료 기준 |
|---|---|---|
| 정확성 | 정상·경계·실패 질문을 자동화합니다. | 핵심 시나리오가 반복 실행되어도 통과합니다. |
| 검색 품질 | context recall·precision과 top-k 결과를 평가합니다. | 정답에 필요한 문서가 허용 범위 내에 검색됩니다. |
| 근거성 | faithfulness와 citation 정확도를 확인합니다. | 문서에 없는 내용을 근거 없이 단정하지 않습니다. |
| 회귀 방지 | 장애 사례를 regression dataset으로 유지합니다. | 같은 오류가 다음 배포에서 재발하지 않습니다. |
| 성능 | ingestion, 검색, rerank와 응답 시간을 측정합니다. | 서비스 지연 시간과 비용 목표를 충족합니다. |
| 운영성 | 로그, metric, alert와 장애 복구 절차를 검증합니다. | 장애 원인과 문서·index 버전을 추적할 수 있습니다. |
마무리
LlamaIndex를 잘 활용하려면 VectorStoreIndex를 생성하는 코드보다 문서 수집, chunking, metadata, 검색, reranking과 평가를 하나의 데이터 파이프라인으로 설계해야 합니다. 작은 평가 데이터셋으로 먼저 검색 전략을 비교하고, 품질 지표와 운영 비용을 기준으로 Agent와 고급 워크플로우를 단계적으로 확장하세요.
- ingestion과 query 파이프라인을 분리합니다.
- Sentence Window, 계층형 chunking과 하이브리드 검색을 비교합니다.
- 복합 질문은 ReAct Agent와 Sub-question 분해를 활용할 수 있습니다.
- 영구 벡터 DB에서는 문서 변경, 삭제와 index 버전을 관리합니다.
- RAGAS와 고정 평가셋으로 검색 및 답변 품질 회귀를 검증합니다.
'개발 가이드 > AI 개발' 카테고리의 다른 글
| [AI 개발] 6. LC LangChain 완전 가이드 (0) | 2026.07.19 |
|---|---|
| [AI 개발] 5. Hugging Face 완전 가이드 (0) | 2026.07.19 |
| [AI 개발] 4. JAX 완전 가이드 (0) | 2026.07.19 |
| [AI 개발] 3. PyTorch 완전 가이드 (0) | 2026.07.19 |
| [AI 개발] 2. C++와 ML/AI 완전 가이드 (0) | 2026.07.19 |


댓글